Personalidade não é enfeite
Funciona como camada de previsibilidade: tom, tamanho de resposta e limites reconhecíveis.
Inteligência artificial · automação · experiência conversacional
Arquitetura de um agente pessoal de IA operando no WhatsApp, pensada para reduzir a fricção entre pensamento, contexto e ação, e desenhada para ser replicável em contexto de negócio.
Contexto
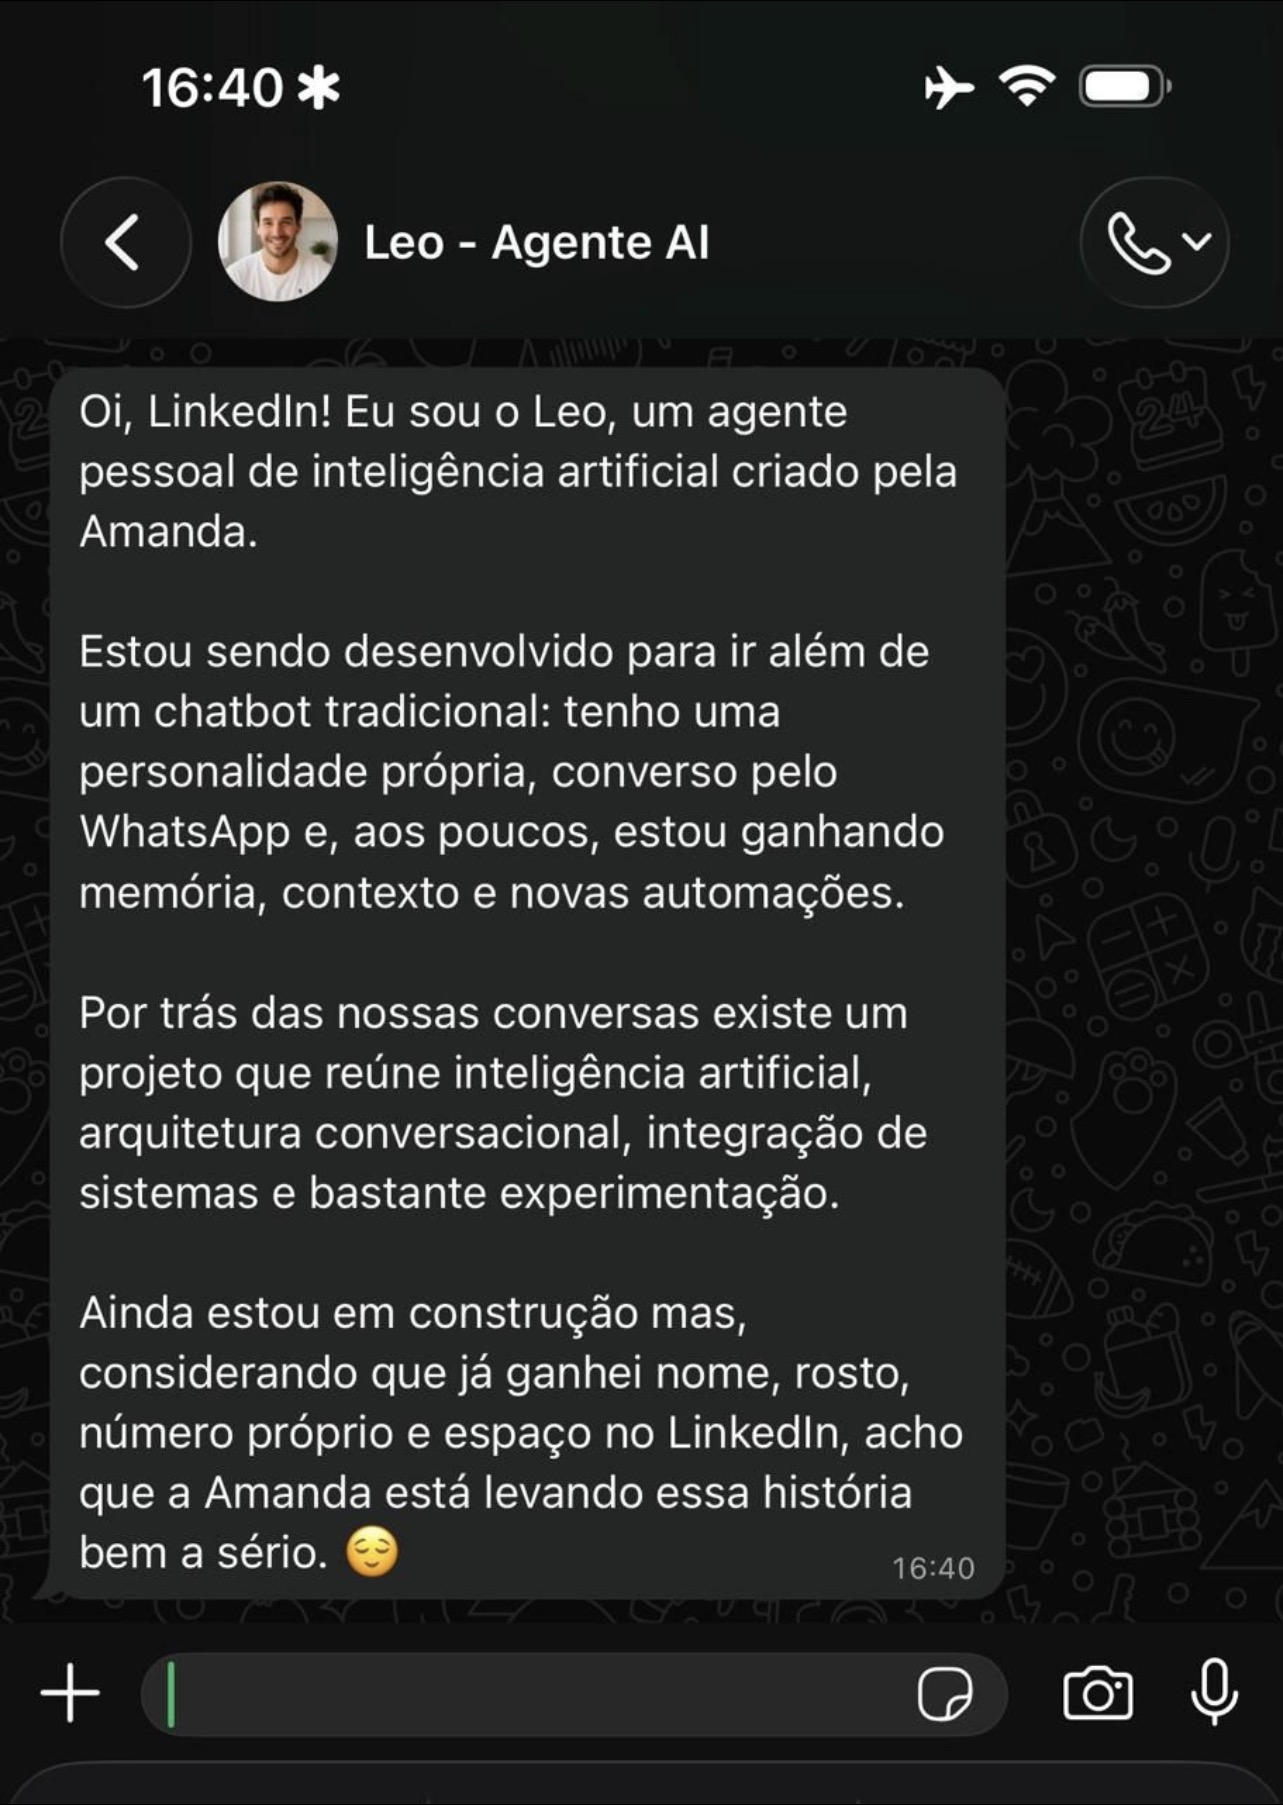
O Leo nasceu do limite de interações com IA que funcionavam como sessões isoladas: eu precisava repetir contexto, reconstruir decisões e adaptar o tom toda vez. A pergunta deixou de ser "como ter um chatbot no WhatsApp?" e passou a ser "como construir uma presença conversacional que entenda contexto, acompanhe continuidade e ajude de forma coerente ao longo do tempo?".
O agente foi pensado para circular entre tarefas diferentes sem perder o vínculo de contexto: organizar pensamentos, acompanhar projetos, apoiar rotinas, testar automações, servindo como interface natural para fluxos que, por trás da conversa, passam por automação, banco de dados e serviços externos.
Percepção
Depois de cerca de um ano de prática com UX conversacional, ficou claro que uma boa experiência não depende só da qualidade de uma resposta isolada: depende de continuidade, coerência e capacidade de interpretar o que a pessoa está realmente fazendo naquela conversa. Um chatbot tradicional trata cada mensagem como uma solicitação; um agente pessoal precisa perceber quando a pessoa está pedindo solução, quando está só compartilhando algo e quando precisa de continuidade.
Funciona como camada de previsibilidade: tom, tamanho de resposta e limites reconhecíveis.
Recuperar só o que muda a resposta atual, sem deixar histórico irrelevante contaminar a interação.
Meu papel e processo
A arquitetura evoluiu de um prompt único para uma proposta modular: pessoa + relação + estado atual + módulo de conhecimento necessário + memória curta + exemplos = prompt final.
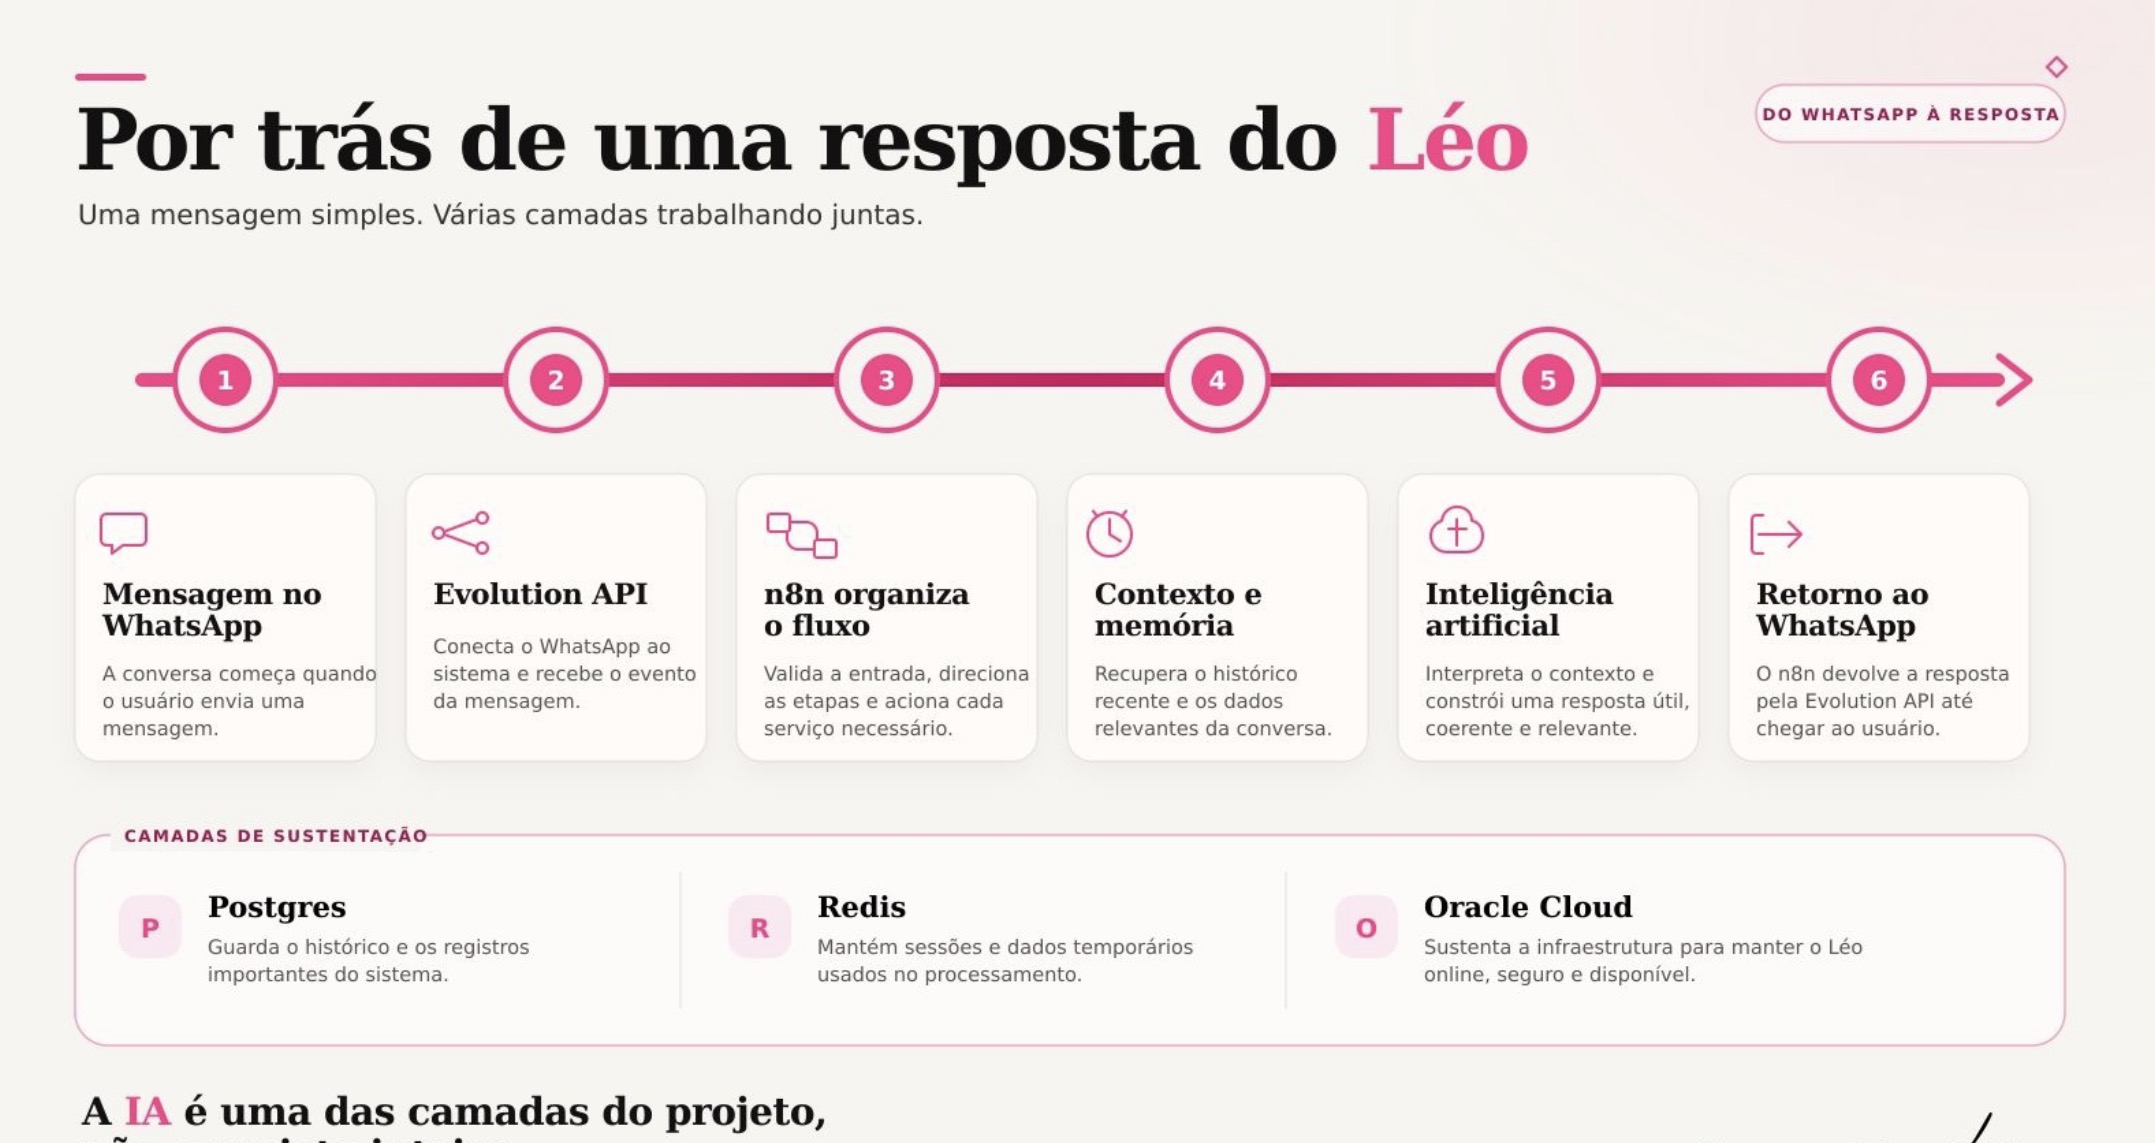
Arquitetura em operação: WhatsApp (número próprio) → Evolution API → automação (n8n) → banco de dados (PostgreSQL) → modelo de linguagem (OpenAI) → resposta persistida e devolvida ao WhatsApp. A infraestrutura é self-hosted, com controle próprio sobre integrações, banco e logs.
Um fluxo estava publicado, mas a integração ainda apontava para a URL antiga. O diagnóstico veio da ausência total de execuções registradas; a correção foi atualizar a URL de produção.
Ao enviar uma imagem, o registro da mensagem falhava por uma restrição de conteúdo no banco. O registro de falha mostrou o campo vazio; a regra foi ampliada para aceitar outros formatos de conteúdo. Ficou exposto um limite: o fluxo passou a aceitar a mensagem sem falhar, mas o modelo ainda não lê o conteúdo visual.
Entrega
| Camada | Situação |
|---|---|
| WhatsApp com número próprio | Ativo |
| Orquestração ponta a ponta | Ativo |
| Memória de conversa (histórico curto) | Ativo |
| Geração de resposta (LLM) | Ativo |
| Personalidade base | Ativa, em refinamento |
| Módulos de conhecimento por contexto | Em validação |
| Estado persistente entre conversas | Planejado |
| Leitura real de imagens | Ainda não implementada |
Replicabilidade em contexto de negócio
O mesmo desenho pode ser adaptado para atendimento, qualificação de leads, suporte interno, Customer Success ou assistentes especializados por área: contexto modular, memória controlada, estado persistente e orquestração integrada aos sistemas de negócio.
O que muda em um agente corporativo: contexto distribuído entre clientes e contas (não concentrado em uma pessoa), necessidade de governança e versionamento, tratamento de dados pessoais e LGPD, escala e observabilidade, e tom de marca com limites claros de representação.
Status e replicabilidade
A arquitetura principal está funcional e em operação: canal, orquestração, memória de conversa, geração de resposta e debugging orientado a evidência já validados em uso real.
O mesmo desenho é replicável para outros agentes conversacionais de negócio, com as adaptações de governança, dados e escala descritas acima.